Futa Waseda
Futa Waseda
Home
Projects
Publications
Contact
CV
EN
日本語
Multimodal Adversarial Defense for Vision-Language Models by Leveraging One-To-Many Relationships
Futa Waseda
,
Antonio Tejero-De-Pablos
,
Isao Echizen
March 2026
Paper
Video
Poster
DOI
GitHub
Cite
TL;DR
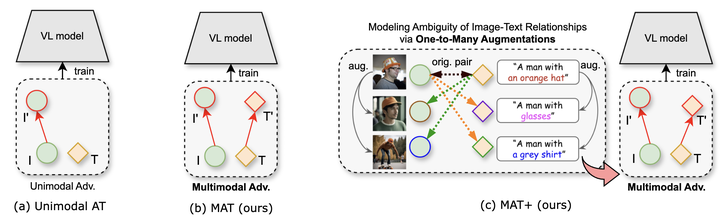
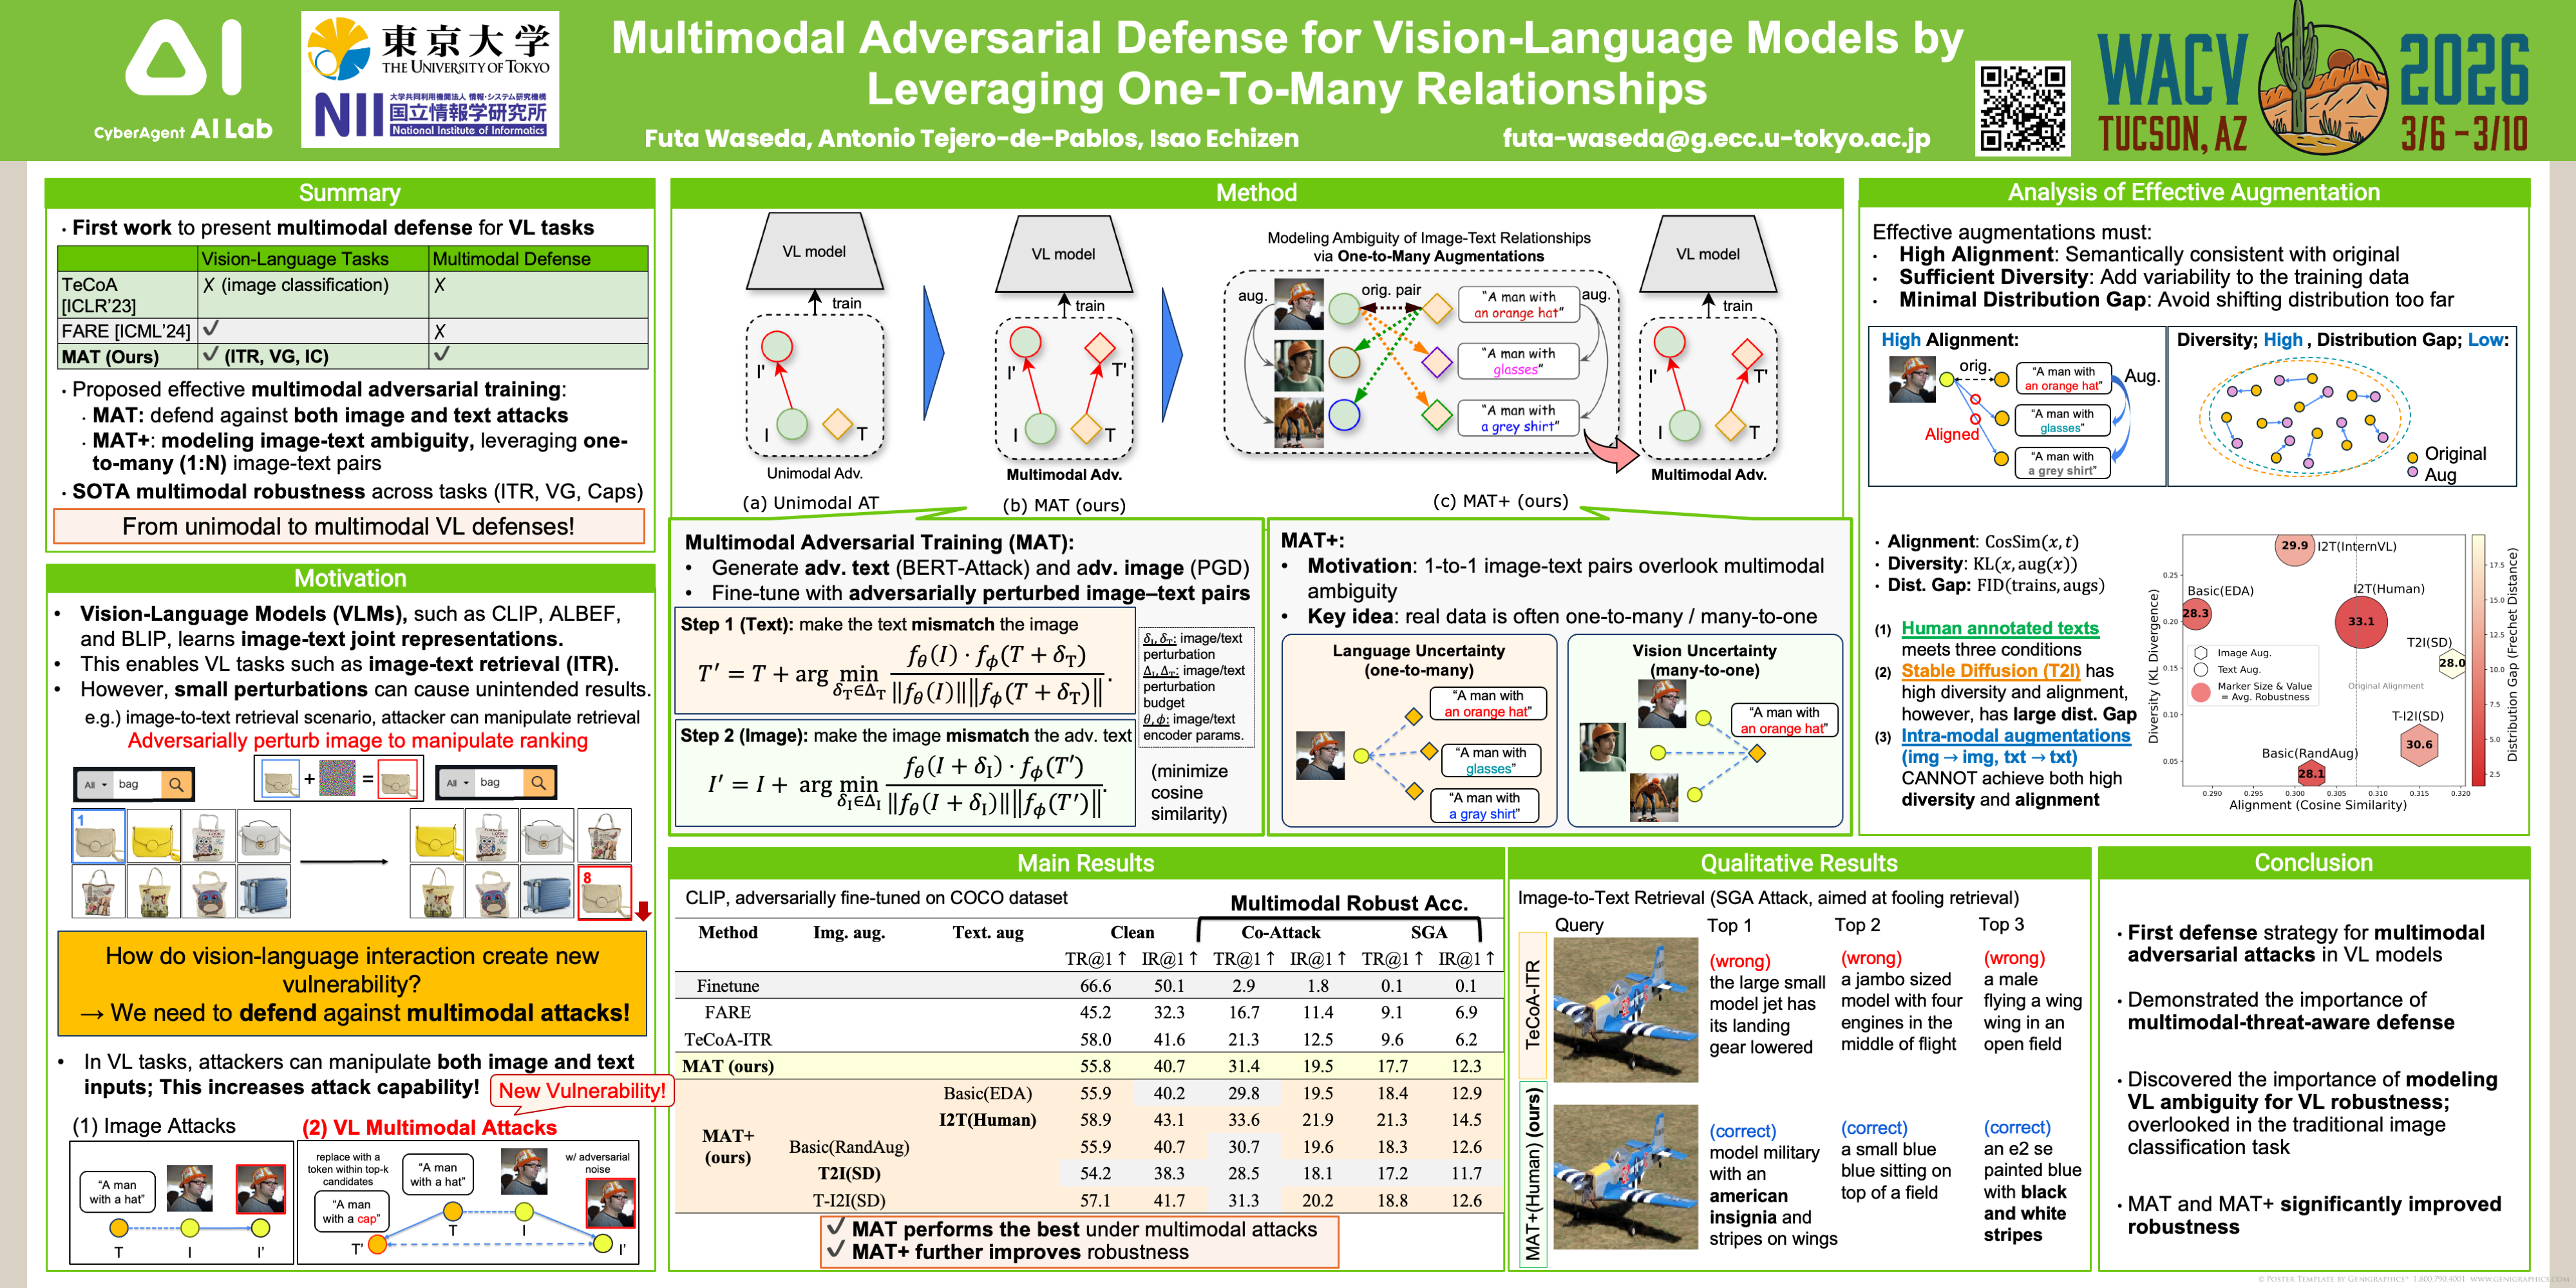
VLMs are defended against image and text attacks
: Multimodal adversarial training addresses attacks on both input modalities.
One-to-many pairs capture image-text ambiguity
: MAT+ uses multiple valid images or descriptions instead of fixed one-to-one supervision.
Multimodal defense reaches state-of-the-art performance
: Improves robustness across vision-language tasks under multimodal attacks.
Type
Conference paper
Publication
WACV 2026
Presentation Video
Presentation Poster
Open poster
Recent
Futa Waseda
Project Assistant Professor
Related
【SMC 2026】Semantic Color Naturalness Breaker: Preventing Illegitimate Colorization via Content-Aware Color Priors
【APSIPA ASC 2025】Uncolorable Examples: Preventing Unauthorized AI Colorization via Perception-Aware Chroma-Restrictive Perturbation
【ACM MM 2025】Quality Text, Robust Vision: The Role of Language in Enhancing Visual Robustness of Vision-Language Models
【ICLR 2025】Rethinking Invariance Regularization in Adversarial Training to Improve Robustness-Accuracy Trade-off
【ICIP 2024】Defending Against Physical Adversarial Patch Attacks on Infrared Human Detection
Cite
×