Futa Waseda
Futa Waseda
Home
Projects
Publications
Contact
CV
EN
日本語
Text-Printed Image: Bridging the Image-Text Modality Gap for Text-centric Training of Large Vision-Language Models
Shojiro Yamabe
,
Futa Waseda
,
Daiki Shiono
,
Tsubasa Takahashi
June 2026
Paper
DOI
Cite
TL;DR
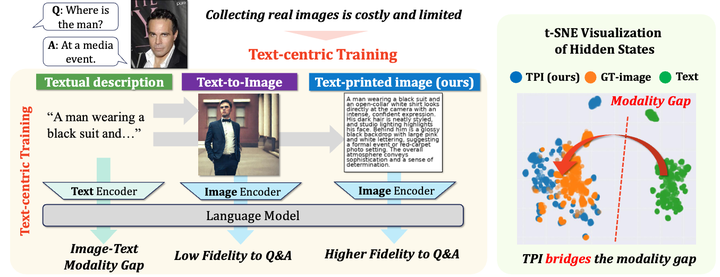
Printed text becomes low-cost VLM training data
: TPI renders textual descriptions directly onto plain white images.
Text rendering bridges the image-text modality gap
: Provides visual training inputs without collecting real images.
TPI outperforms diffusion-generated training images
: Preserves semantic accuracy and improves results across multiple benchmarks.
Type
Conference paper
Publication
CVPR 2026
Recent
Futa Waseda
Project Assistant Professor
Related
【ECCV 2026】Read or Ignore? A Unified Benchmark for Typographic-Attack Robustness and Text Recognition in Vision-Language Models
【ICLR 2026】Understanding Sensitivity of Differential Attention through the Lens of Adversarial Robustness
【ACL 2025 Main】MergePrint: Merge-Resistant Fingerprints for Robust Black-box Ownership Verification of Large Language Models
【SMC 2026】Semantic Color Naturalness Breaker: Preventing Illegitimate Colorization via Content-Aware Color Priors
【APSIPA ASC 2025】Uncolorable Examples: Preventing Unauthorized AI Colorization via Perception-Aware Chroma-Restrictive Perturbation
Cite
×