Multimodal Adversarial Defense for Vision-Language Models by Leveraging One-To-Many Relationships
TL;DR
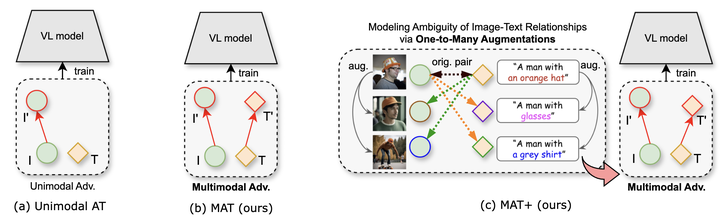
- 画像とテキストの両方への攻撃からVLMを防御:マルチモーダル敵対的学習で両入力への攻撃を考慮。
- 1対多の対応で画像と言語の曖昧性を学習:MAT+は固定的な1対1対応ではなく、複数の妥当な画像・説明を活用。
- マルチモーダル防御で最高水準の性能を達成:複数の視覚言語タスクでマルチモーダル攻撃への頑健性を改善。
収録
WACV 2026
発表動画
発表ポスター