Quality Text, Robust Vision: The Role of Language in Enhancing Visual Robustness of Vision-Language Models
TL;DR
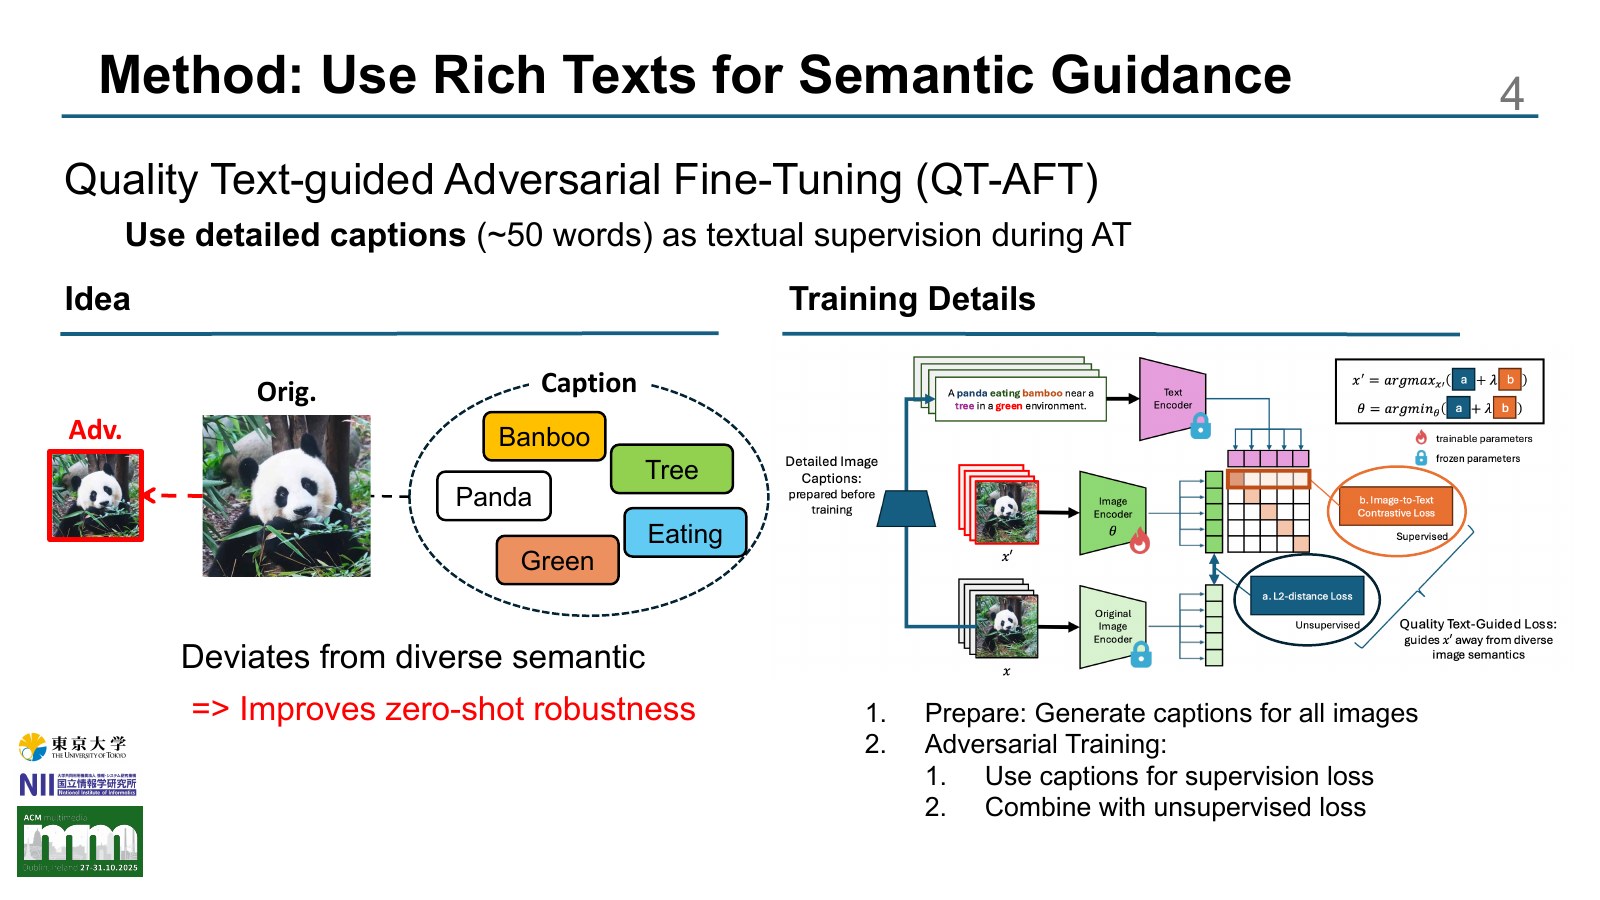
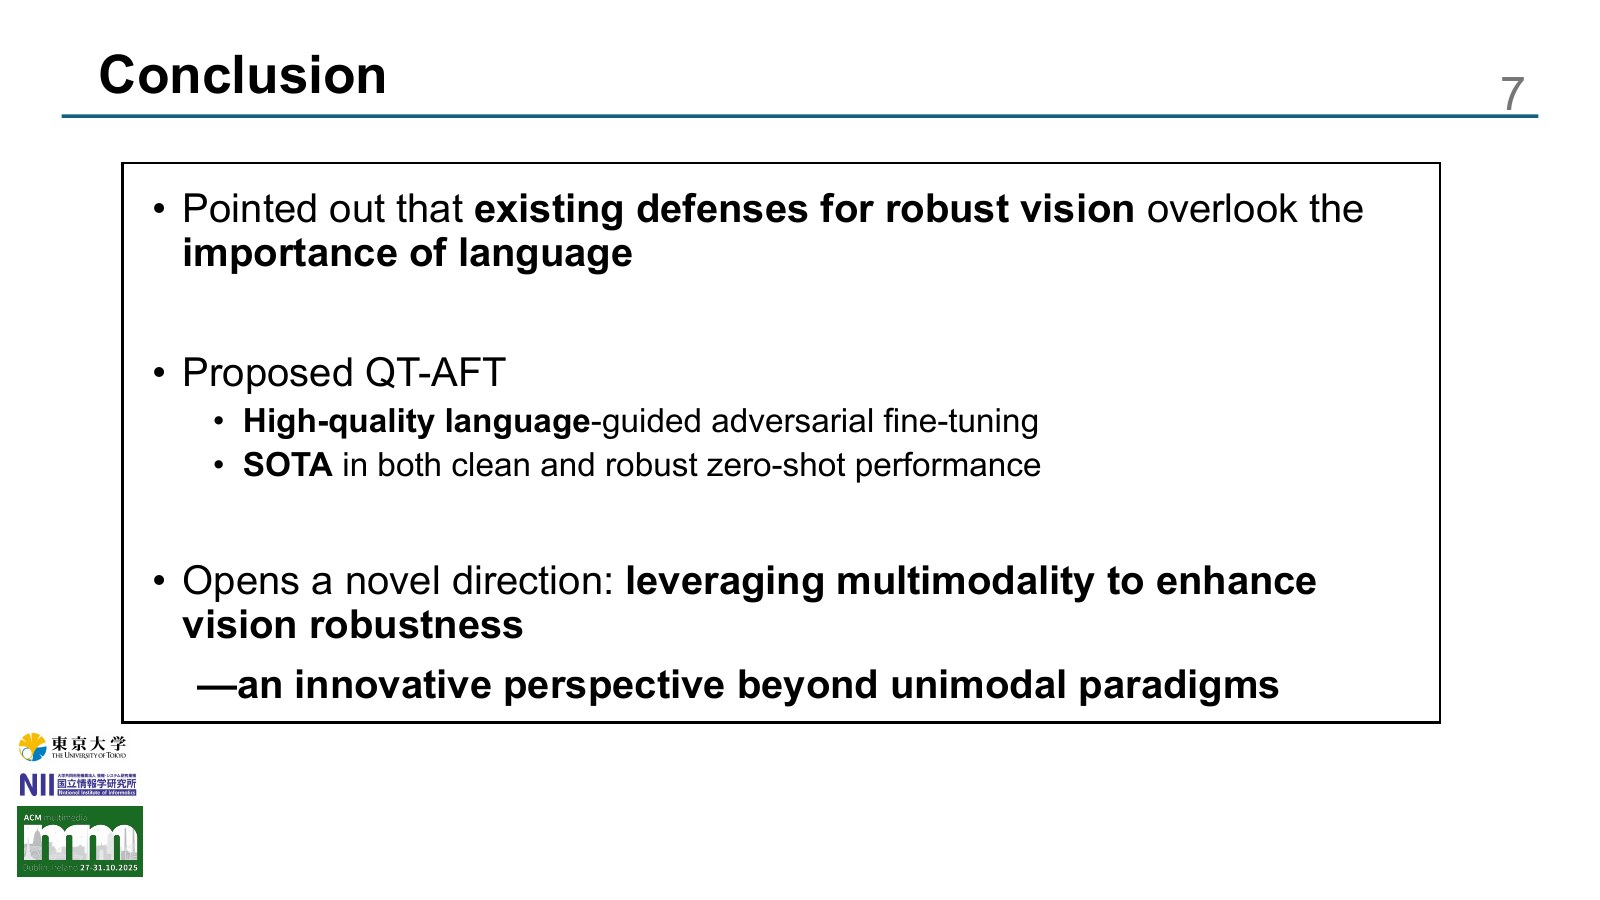
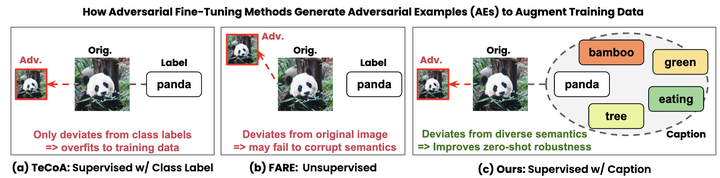
- 高品質なキャプションで敵対的学習を誘導:QT-AFTはクラス名だけでなく豊かな画像説明を活用。
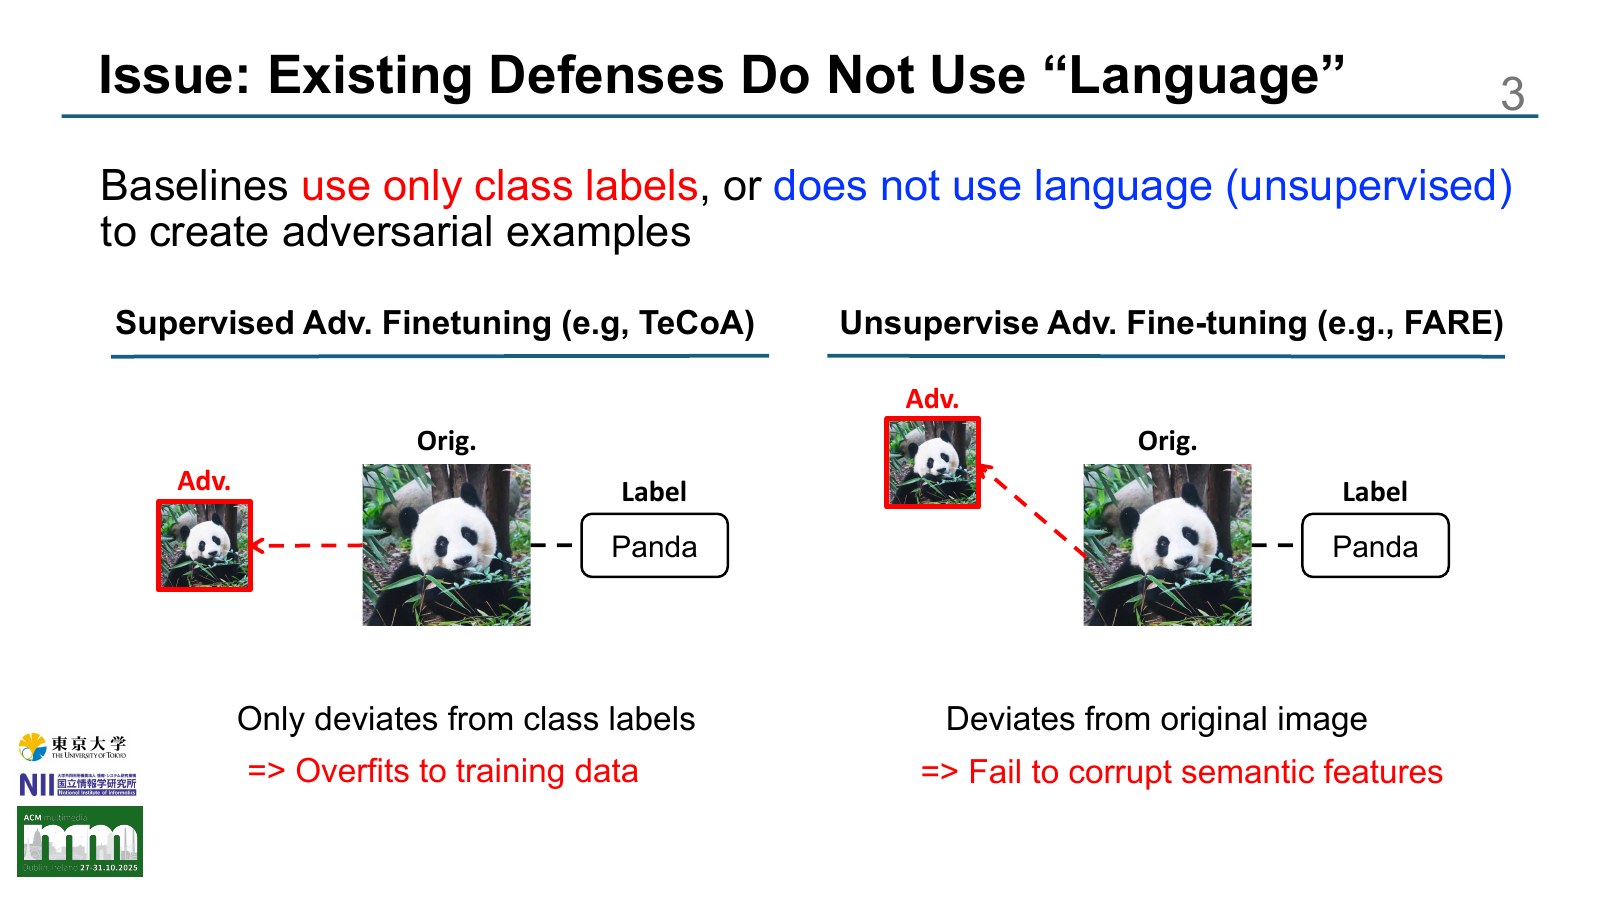
- 豊かな言語情報で視覚の頑健性を向上:多様な意味から離れる攻撃を学習し、特定クラスへの過適合を抑制。
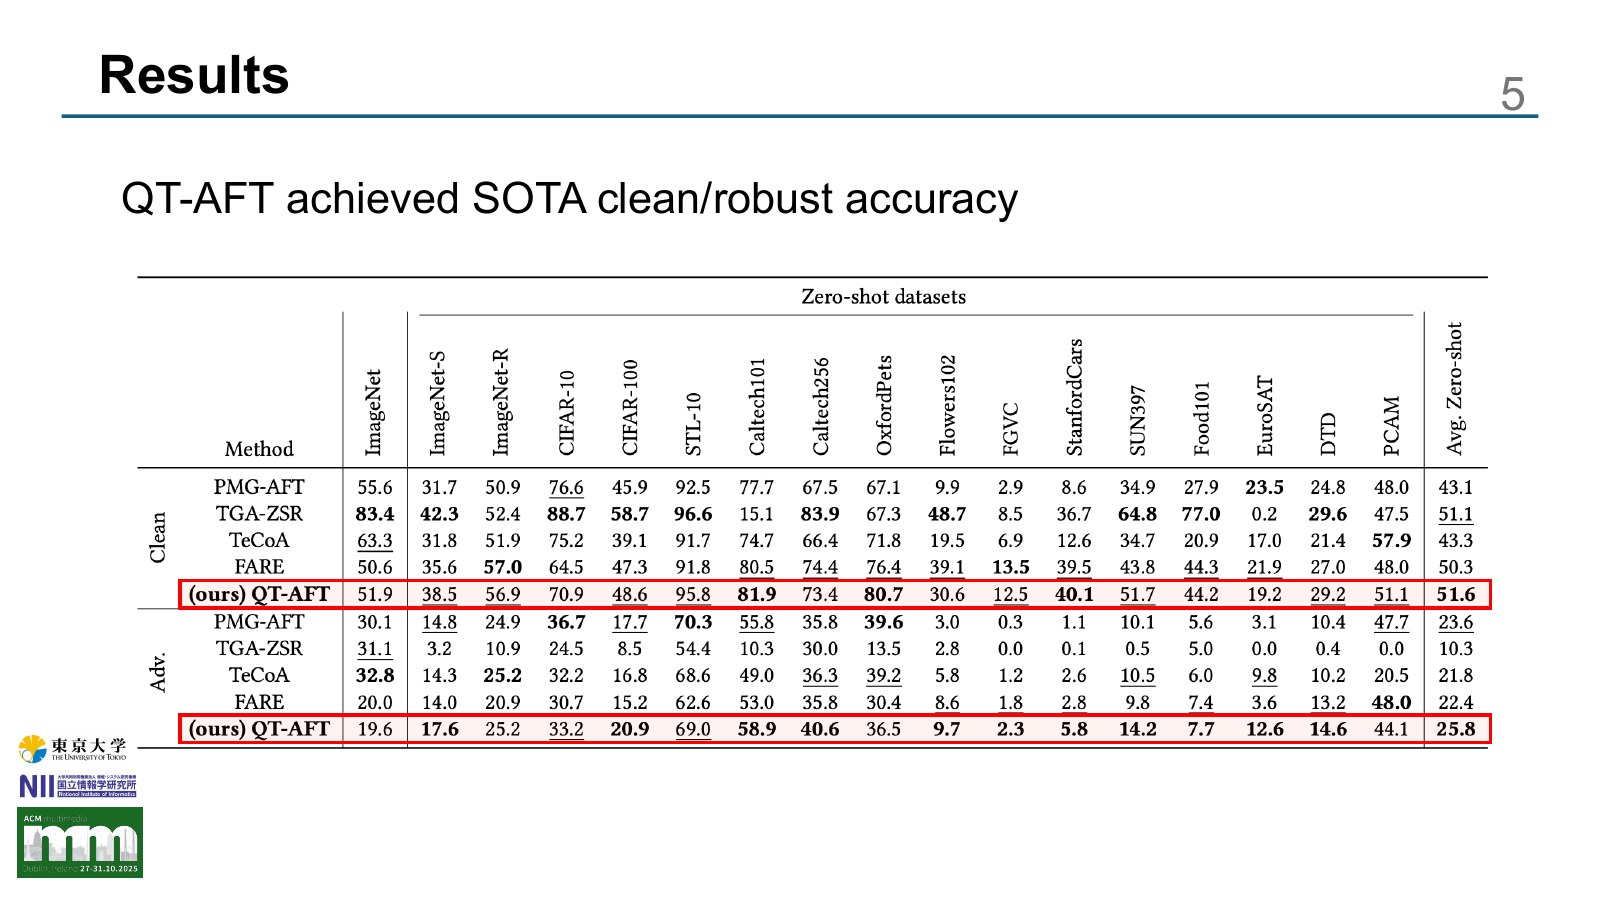
- 16データセットで頑健性と精度を改善:多様な下流分類タスクへのゼロショット転移で検証。
収録
ACM Multimedia 2025
発表動画
発表スライド