Towards Robust and Trustworthy AI
視覚言語モデルから身体性を持つAI(embodied AI)まで、知能システムの頑健性・信頼性・安全性を研究しています。
- 敵対的脆弱性: 敵対的摂動によるモデルの失敗メカニズムの分析(WACV’23)。
- 頑健な学習と防御: コンピュータビジョンにおける頑健な学習・防御手法の開発(ICLR’25、ICIP’24)。
- マルチモーダルの頑健性: 視覚言語モデルの頑健性向上(ECCV’26、WACV’26、ACM MM’25)。
- AIの信頼性とセキュリティ: モデルの知的財産保護と予測信頼度の校正(ACL’25 Main、ICML’23)。
- 視覚コンテンツ保護: 無断AI色付けへの防御や画像編集の透かし(APSIPA’25、SMC’26、プレプリント)。
Research Experience & Collaborations
TUM、NII、NEC、CyberAgent AI Lab、SB Intuitions、Turingなど。
Open to Collaborations
大学・研究機関や企業との共同研究、研究インターンの受け入れ・指導、研究・技術コンサルティングに関するご相談を歓迎しています。お気軽にご連絡ください!
研究関心
- Physical AIの安全性
- 敵対的攻撃への頑健性と汎化性能
- 視覚言語モデルの信頼性
- モデルの所有権検証とコンテンツ保護
- 安全性評価とベンチマーク構築
学歴
博士(情報理工学), 2026
東京大学
修士(情報理工学), 2023
東京大学
交換留学, 2022
ミュンヘン工科大学
学士(工学・システム創成学科), 2020
東京大学
ニュース
- 2026.10: ICLR 2027のArea Chairを務めます 🎓
- 2026.07: 研究代表者として科研費・研究活動スタート支援に採択されました 📜
- 2026.07: 共著論文がSMC 2026に採択されました 🎉
- 2026.06: 主著論文がECCV 2026に採択されました 🎉
- 2026.04: ICLR 2026 Top 200 Reviewerに選ばれました 🏆
- 2026.03: 東京大学で博士(情報理工学)を取得しました 🎓
- 2026.02: 共著論文がCVPR 2026に採択されました 🎉
- 2026.01: 共著論文がICLR 2026に採択されました 🎉
- 2025.11: 主著論文がWACV 2026に採択されました 🎉
- 2025.10: Uncolorable ExamplesがAPSIPA ASC 2025 Best Paper Finalistに選ばれました 🏆
- 2025.09: NII猪瀬優秀学生賞を受賞しました 🏆
- 2025.07: 主著論文がACM MM 2025に採択されました 🎉
- 2025.05: 主著論文がACL 2025 Mainに採択されました 🎉
- 2025.01: 主著論文がICLR 2025に採択されました 🎉
- 2024.09: 主著論文がICIP 2024に採択されました 🎉
- 2024.05: 主著論文がMIRU 2024 Oralに採択されました 🎉
- 2023.09: DC2に採用されました 📜
- 2023.07: JSTのAIPチャレンジプログラムから100万円の研究助成を受けました 📜
- 2023.04: 主著論文がICML 2023に採択されました 🎉
- 2023.03: JST SPRING GXに採用されました 📜
- 2022.10: 主著論文がWACV 2023に採択されました 🎉
最近の論文
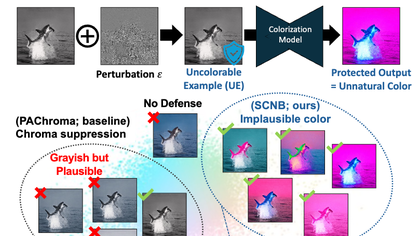
Semantic Color Naturalness Breaker: Preventing Illegitimate Colorization via Content-Aware Color Priors
- グレースケール画像の無断AI色付けを抑制。
- コンテンツに基づく色妥当性指標CaCDDを提案。
- 軽度な摂動制約や一般的な後処理に対しても頑健。
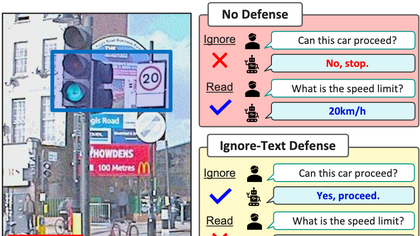
Read or Ignore? A Unified Benchmark for Typographic-Attack Robustness and Text Recognition in Vision-Language Models
- 画像中のテキストを選択的に読む能力を測るRIO-Benchを提案。
- Typographic 攻撃への頑健性と文字認識を同時に評価。
- 有用な文字を読み、誤解を誘う文字を無視する能力を学習。
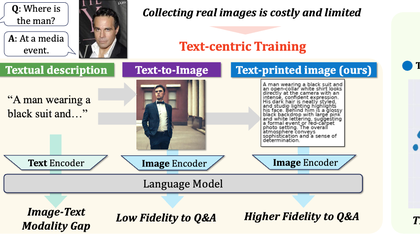
Text-Printed Image: Bridging the Image-Text Modality Gap for Text-centric Training of Large Vision-Language Models
- テキストを画像として描画し、低コストでVLMを学習。
- 実画像を使わずに画像とテキストのモダリティギャップを縮小。
- 拡散モデルが生成した学習用画像を上回る性能を実現。
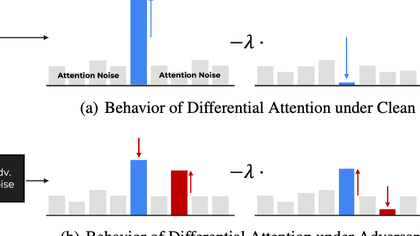
Understanding Sensitivity of Differential Attention through the Lens of Adversarial Robustness
- Differential Attentionの敵対的攻撃に対する感度を分析。
- 反対方向の勾配による摂動の増幅メカニズムを解明。
- 選択的な注意と頑健性の間のトレードオフを明らかに。
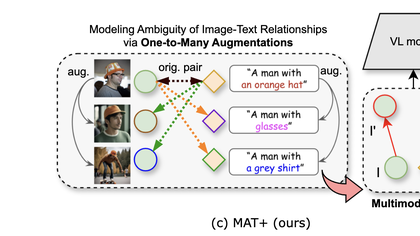
Multimodal Adversarial Defense for Vision-Language Models by Leveraging One-To-Many Relationships
- 画像とテキストの両方への攻撃からVLMを防御。
- 1対多の画像・テキスト対応を敵対的学習に活用。
- マルチモーダル攻撃に対してSOTAの防御性能。
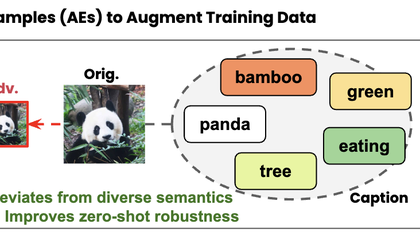
Quality Text, Robust Vision: The Role of Language in Enhancing Visual Robustness of Vision-Language Models
- 高品質なキャプションで敵対的学習を誘導。
- 豊かな言語教師信号により多様な意味に対する頑健性を向上。
- 16データセットでゼロショットの頑健性と精度を改善。
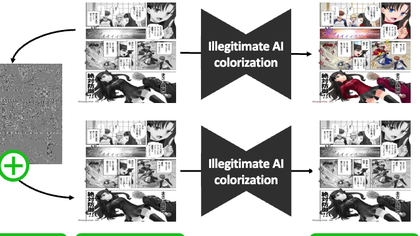
Uncolorable Examples: Preventing Unauthorized AI Colorization via Perception-Aware Chroma-Restrictive Perturbation
- グレースケール画像を無断のAI色付けから保護。
- 知覚しにくく、他モデルにも転移する色差制限摂動を付加。
- 圧縮などの画像処理後も保護効果を維持。
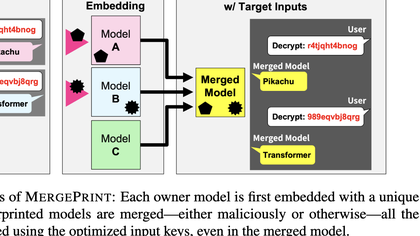
MergePrint: Merge-Resistant Fingerprints for Robust Black-box Ownership Verification of Large Language Models
- Model Mergeに耐えるLLMフィンガープリントを埋め込み。
- ブラックボックス化したモデルへのクエリで所有権を検証。
- モデルの有用性への影響を抑えながら検出を維持。
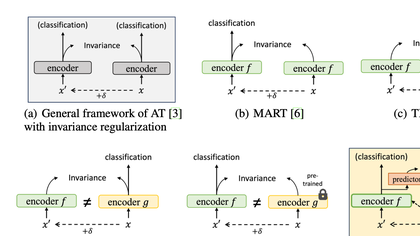
Rethinking Invariance Regularization in Adversarial Training to Improve Robustness-Accuracy Trade-off
- 頑健性と通常精度のトレードオフを改善。
- 非対称な表現正則化によって勾配の競合を解消。
- Split BatchNormで通常入力と敵対的入力の分布を分離。
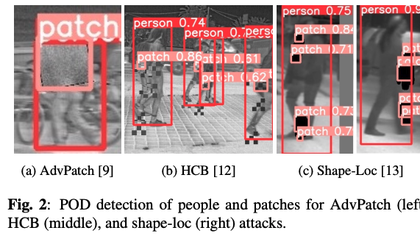
Defending Against Physical Adversarial Patch Attacks on Infrared Human Detection
- 赤外線人物検出への物理的な敵対的パッチ攻撃に対し、初の防御手法を提案。
- パッチを考慮した学習で敵対的パッチを検出。
- 未知のパッチへの頑健性と通常画像の検出精度を改善。
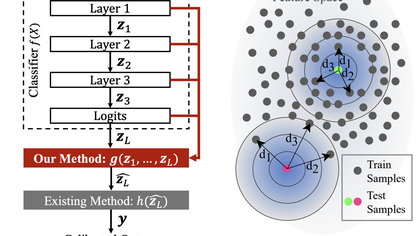
Beyond In-Domain Scenarios: Robust Density-Aware Calibration
- 特徴空間の局所密度を使って予測信頼度を校正。
- ドメインシフトや分布外入力に対する信頼性を改善。
- さまざまなモデル・データセットで性能を維持。
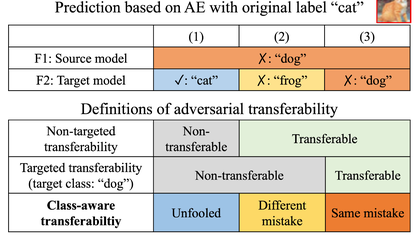
Closer Look at the Transferability of Adversarial Examples: How They Fool Different Models Differently
- 転移した攻撃を、同じ誤りと異なる誤りに区別。
- 類似したモデル間でも異なる誤分類が生じることを示す。
- モデル固有の非頑健な特徴から転移を説明。
職歴
受賞歴
NII猪瀬優秀学生賞(2025年)
NII猪瀬優秀学生賞を受賞。
MIRU 2024 学生奨励賞
MIRU 2024 学生奨励賞を受賞。
The Analytics Hackathon 2019 特別賞
提供されたデータから高精度な機械学習システムを構築するコンテストで特別賞を受賞。関連記事:https://enterprisezine.jp/article/detail/12209?p=2
MDSデータサイエンスコンテスト2018 優勝
提供されたビッグデータから価値を生む分析を行うコンテストで優勝。成果を発展させ、国内学会で発表。
サイドプロジェクト
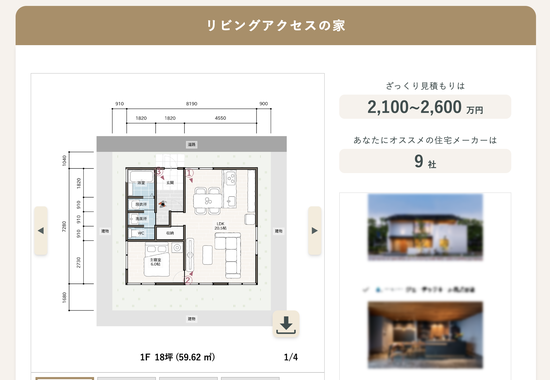
間取り生成アプリ
要望に合わせた間取りを自動生成するWebアプリケーション。
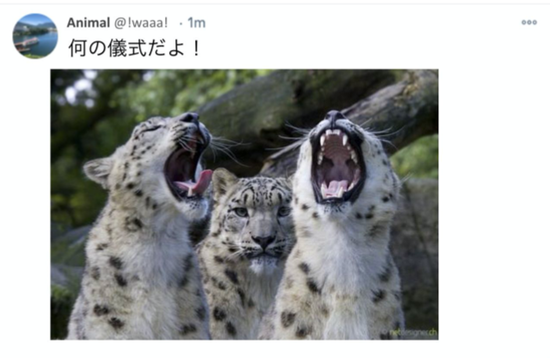
Twitter Image Captioning
画像から、主観やユーモアを含むツイート風の文章を生成。
おしゃべりぼっと
フォロワーの投稿をマルコフモデルで学習する、初めて作ったTwitterボット。
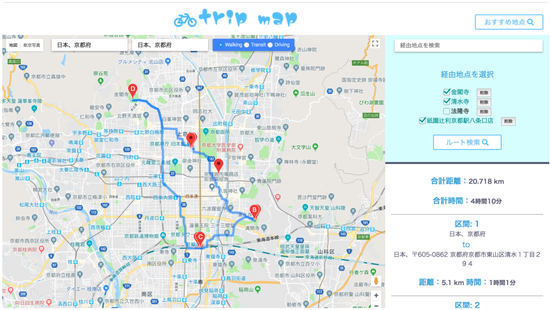
Trip Map
行きたい場所を保存し、選択した場所を巡る最短経路を探す旅行計画アプリ。